Architecture Informatique de Nouvelle Génération : Rendre les Supercalculateurs Plus Rapides, Plus Simples et Plus Fiables
## 1. Quel est le problème fondamental des serveurs actuels ?
Aujourd'hui, l'ensemble de l'industrie du cloud computing et de l'intelligence artificielle repose sur des règles établies il y a 30 ans. Une baie de serveurs standard est une étagère métallique encombrante composée de boîtiers reliés par des kilomètres de câbles en cuivre et des commutateurs (switches) centraux complexes.
Cette architecture a atteint ses limites physiques pour trois raisons déterminantes :
- **Le cuivre ne peut plus suivre la cadence des vitesses requises.** Aux fréquences actuelles, le signal électrique dans le cuivre s'atténue et se déforme au bout de seulement 15 à 20 centimètres. Pour acheminer le signal du processeur à la carte réseau, les ingénieurs doivent implanter des chaînes de puces amplificatrices dédiées qui surchauffent et gaspillent une énergie colossale.
- **Le paradoxe de la mémoire serveur.** Pour doter un serveur d'un téraoctet de RAM, les fabricants ajoutent des puces tampons (buffers) sur les barrettes de mémoire. En raison de ces composants intermédiaires, la mémoire serveur s'avère plus lente que celle d'un ordinateur de bureau compact, dont les pistes courtes relient directement la mémoire au processeur pour une réactivité 30 à 40 % plus rapide.
- **Une lourdeur logicielle disproportionnée.** Un Linux pour serveur conventionnel met une minute entière à démarrer, contient des millions de lignes de code obsolète et gaspille jusqu'au tiers des cycles CPU à déplacer de simples données d'un tampon mémoire interne à un autre.
Nous avons repensé le système informatique à partir d'une feuille vierge, éliminant chacun de ces goulots d'étranglement.
## 2. La géométrie compte : Pourquoi notre serveur est rond (Tore)
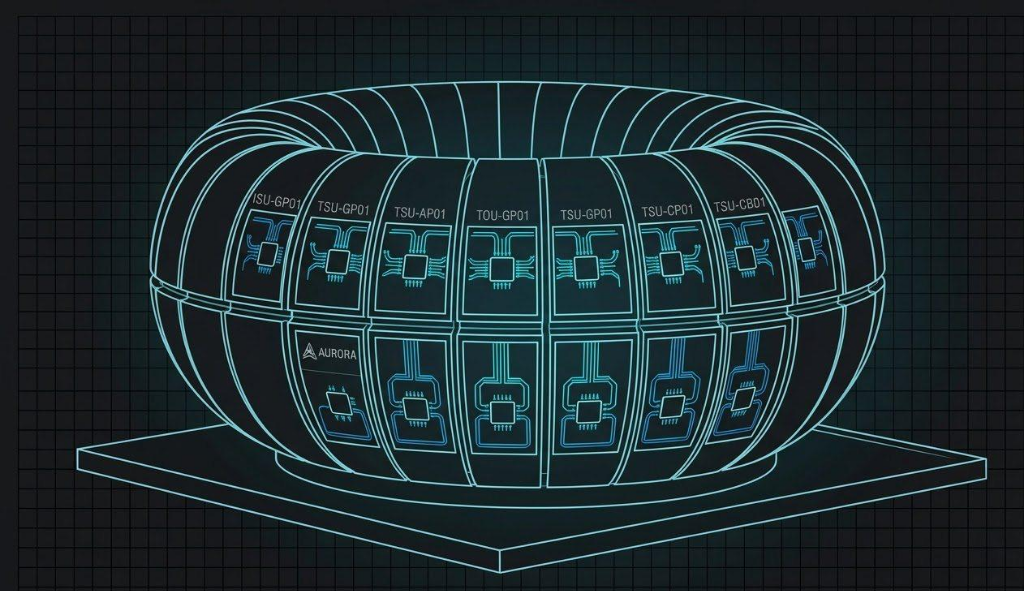
Plutôt qu'un rack rectangulaire plat, notre système prend la forme d'un anneau monolithique : un tore (« donut »). Ce choix découle de lois physiques strictes :
- **Le trajet le plus court pour les données.** Dans une baie standard, le signal allant du serveur supérieur au serveur inférieur parcourt 2 à 3 mètres de câblage et transite par un commutateur central. Dans un anneau fermé, la distance entre deux unités quelconques est minimale : tous les processeurs se situent « à portée de main » le long du cercle.
- **La lumière à la place du cuivre (Photonique).** À l'intérieur de l'anneau, les données ne circulent plus sur des conducteurs en cuivre, mais sous forme d'impulsions lumineuses à travers des micro-canaux optiques. La lumière ne dégage aucune chaleur sur la carte, demeure insensible aux interférences électromagnétiques et décuple les débits de transmission.
- **Refroidissement par tirage thermique naturel (Effet cheminée).** Les salles de serveurs classiques imposent une climatisation complexe séparant les allées chaudes et froides. Notre châssis circulaire aspire l'air frais extérieur sur l'intégralité de son périmètre (360 degrés), refroidit les composants et évacue l'air chaud vers le haut par une colonne centrale grâce au tirage convectif naturel secondé par un ventilateur central silencieux à basse vitesse.
## 3. Modularité totale : Le supercalculateur comme un jeu de construction
Le système complet se compose de modules-segments transparents et indépendants disposés le long de la circonférence :
- **Des modules dédiés par fonction :** Un module doté de processeurs centraux (pour le calcul générique), un module équipé d'accélérateurs neuronaux (pour les charges d'intelligence artificielle) et un module pourvu de stockage ultra-rapide (pour les bases de données).
- **Connecteur optique en U :** Chaque module s'enfiche sur l'anneau commun via une pince de verrouillage qui épouse le bus optique circulaire des deux côtés.
- **Remplacement à chaud sans outils :** Le connecteur utilise des micro-lentilles qui élargissent le faisceau lumineux. Le contact optique devient ainsi insensible à la poussière et aux micro-vibrations, tandis que des glissières magnétiques guident et centrent le module avec une précision absolue.
## 4. Liaison directe : Pourquoi nous avons supprimé les commutateurs réseau
Dans les centres de données habituels, la communication entre machines exige un commutateur réseau central imposant et complexe. Nous avons supprimé ce relais intermédiaire pour relier les processeurs directement en boucle grâce à la technologie **Zero-Copy DMA (Accès direct à la mémoire sans copie)** :
- Le processeur d'un nœud peut inscrire instantanément des données directement dans la mémoire vive de son voisin, sans passer par les piles logicielles de protocoles réseau, le système d'exploitation ni des mémoires tampons intermédiaires.
- Le temps de réponse entre nœuds chute de 25–30 microsecondes à seulement **1,5–2 microsecondes**, égalant les supercalculateurs spécialisés les plus onéreux au monde.
- **Auto-réparation en une fraction de milliseconde :** Si un serveur de l'anneau venait à s'éteindre ou à défaillir, les nœuds adjacents inversent instantanément le sens de transmission des flux de données via un second circuit de secours.
## 5. Système d'exploitation propriétaire : ALLIUM HCOS
Nous avons développé le système d'exploitation sur mesure **ALLIUM HCOS**, guidé par trois piliers fondamentaux :
- **Invulnérabilité (Système immuable « gelé »).** L'image du système d'exploitation est verrouillée en lecture seule. Ni une coupure de courant inopinée, ni une fausse manipulation, ni un logiciel malveillant ne peuvent corrompre ou altérer le système.
- **Démarrage instantané en 0,05 seconde.** Nous avons expurgé le noyau de tout composant superflu et conçu un micro-chargeur de démarrage en Rust. Le système s'initialise en 50 millisecondes (1 000 fois plus rapidement qu'un Linux standard).
- **Déploiement Zero-Touch.** Les modules sont branchés, s'identifient mutuellement par voie optique en 3 à 5 secondes et s'agrègent automatiquement au sein d'une grappe unifiée.
## 6. Une approche novatrice des bases de données
Nous avons dissocié le calcul du stockage :
- Le processeur chargé de traiter les requêtes applicatives ne conserve pas la base de données sur son disque local.
- Toutes les transactions sont répliquées instantanément via le bus optique dans la mémoire vive de **trois machines adjacentes**, à une vitesse des centaines de fois supérieure à l'écriture sur le SSD le plus rapide du marché.
- La perte de données devient physiquement impossible : même en cas de panne totale du nœud principal, l'historique complet de ses dernières opérations est déjà consigné dans la RAM de ses voisins.
7. Gestion intelligente de la charge
- **Pool unifié de mémoire graphique pour l'IA.** Tous les modules de l'anneau fédèrent leur mémoire VRAM en un gigantesque espace partagé, autorisant l'exécution de modèles de langage géants sans nécessiter l'achat de cartes graphiques rares et aux prix exorbitants.
- **Veille profonde et réveil instantané (Scale-to-Zero).** Lorsqu'un service ne reçoit aucune sollicitation, son module bascule en veille à consommation quasi nulle. Dès la première requête entrante, il se réveille en 0,08 seconde seulement.
---
**Conclusion majeure :** Notre initiative constitue une refonte intégrale de l'architecture des supercalculateurs : géométrie toroïdale, photonique sur silicium, interconnexion directe processeur-mémoire et système d'exploitation dédié en Rust au démarrage quasi instantané. Cette approche permet de condenser la puissance brute d'un centre de données entier au sein d'un monobloc compact, fiable et d'une remarquable efficacité énergétique.